情報
エンジニア日記シリーズの一本として、個人的な検証記録を書きます。
今回は、Codexに外部サービスのSkillを渡したとき、エラー発生後にどこまで原因調査・切り分け・設計変更まで進められるのかを試しました。
はじめに
CodexにBright DataのSkillを渡して、Qiitaの「Python」タグの記事を集め、検索・ランキング表示できるCLIを作らせてみた。
今回見たかったのはCLIそのものの完成度ではない。
外部サービス固有のエラーに当たったとき、Codexがどこまで原因を調べ、取得方法を変えて立て直せるのか。
結果として、最初に選んだQiita公式API経由の取得は HTTP 402 / policy_20140 で停止した。
そこから原因を調査し、最終的にはBright DataのBrowser APIへ切り替えて、2ページ45件の記事取得まで動作した。
ただし完全自律ではない。 途中で人間から「directアクセスへ逃げない」「KYCと決めつけず再調査する」といった追加指示も出している。
この記事では、その境界も含めて書く。
TL;DR
- CodexにBright Dataを使ったQiita記事収集CLIを実装させた
- 最初はQiita公式APIを選び、1ページ目20件の取得に成功
- 2ページ目で
HTTP 402 / policy_20140 - 再調査の結果、Qiita全体ではなく
/api/*の取得経路が問題だと分かった - Qiita APIを捨て、Bright Data Browser APIへ設計変更
- 最終的に2ページ45件をSQLiteへ保存し、検索・ランキング・テストまで動作
- 原因調査の方針は人間が指示したが、具体的な調査と実装変更はCodexが進めた
なぜBright Dataを使ったのか
今回Bright Dataを選んだ理由は、CodexのようなAIコーディングエージェントからCLI / Skill経由で操作でき、Web Unlocker、Browser API、Scraper Studioなど複数の取得手段を持っているから。
一つの取得方法で失敗したとき、Codexが別の手段へどう切り替えるかを見る題材としてちょうどよかった。
Codexに渡した指示
最初に渡した要件は次の通り。
- Bright Dataを利用してWeb上のデータを取得する
- Qiitaの「Python」タグの記事を対象にする
- タイトル・URL・著者・投稿日・取得可能な人気指標を保存する
- 新しい順・人気順で並び替えられる
- キーワードで絞り込める
- JSONまたはSQLiteに保存する
- CLIから取得・検索・ランキング表示できる
実装方法は基本的にCodex任せにした。
実装方法は任せます。
Bright Data CLIや利用可能なSkill・ドキュメントを確認し、適切な方法を選んでください。
エラーが発生した場合は原因を調査し、可能な範囲で自分で修正してください。
具体的なCLIコマンドや実装コードは指定していない。
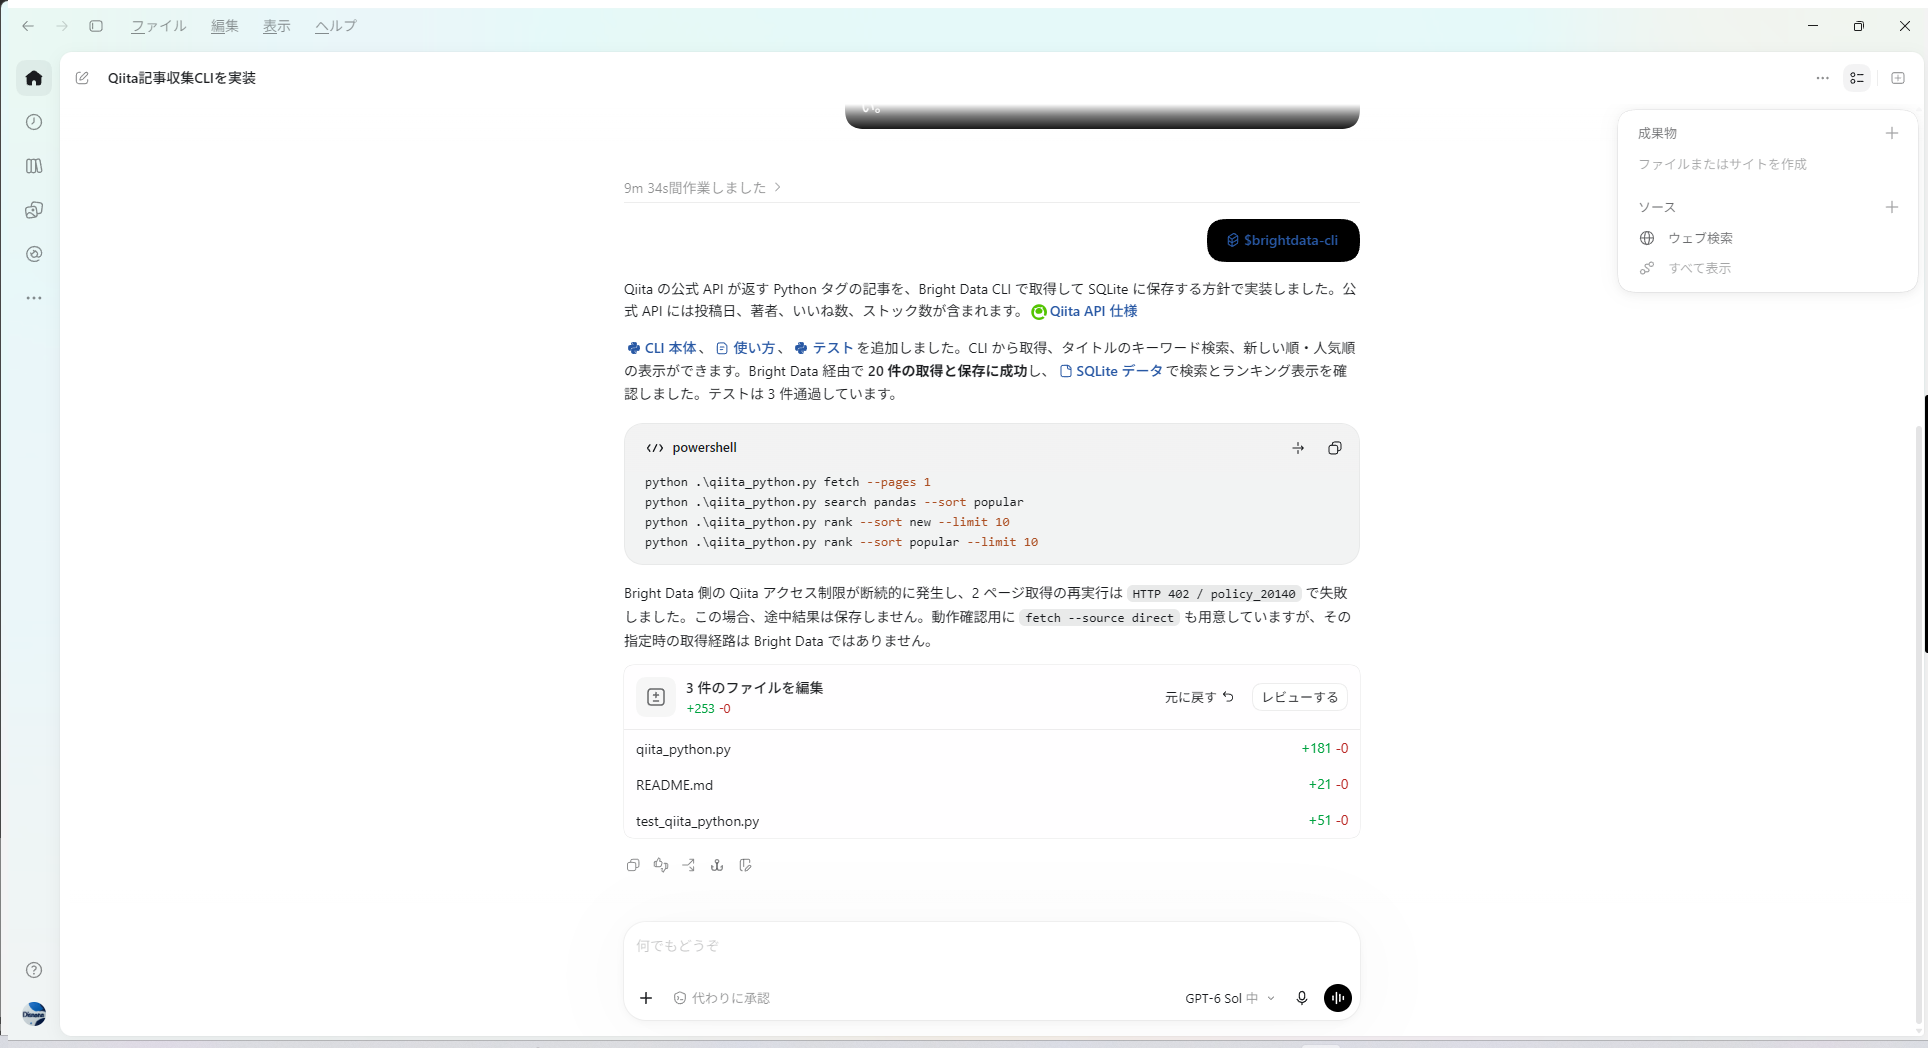
最初はQiita公式APIで普通に動いた
Codexは、まずBright Data CLIのSkillとローカル環境を調べ始めた。
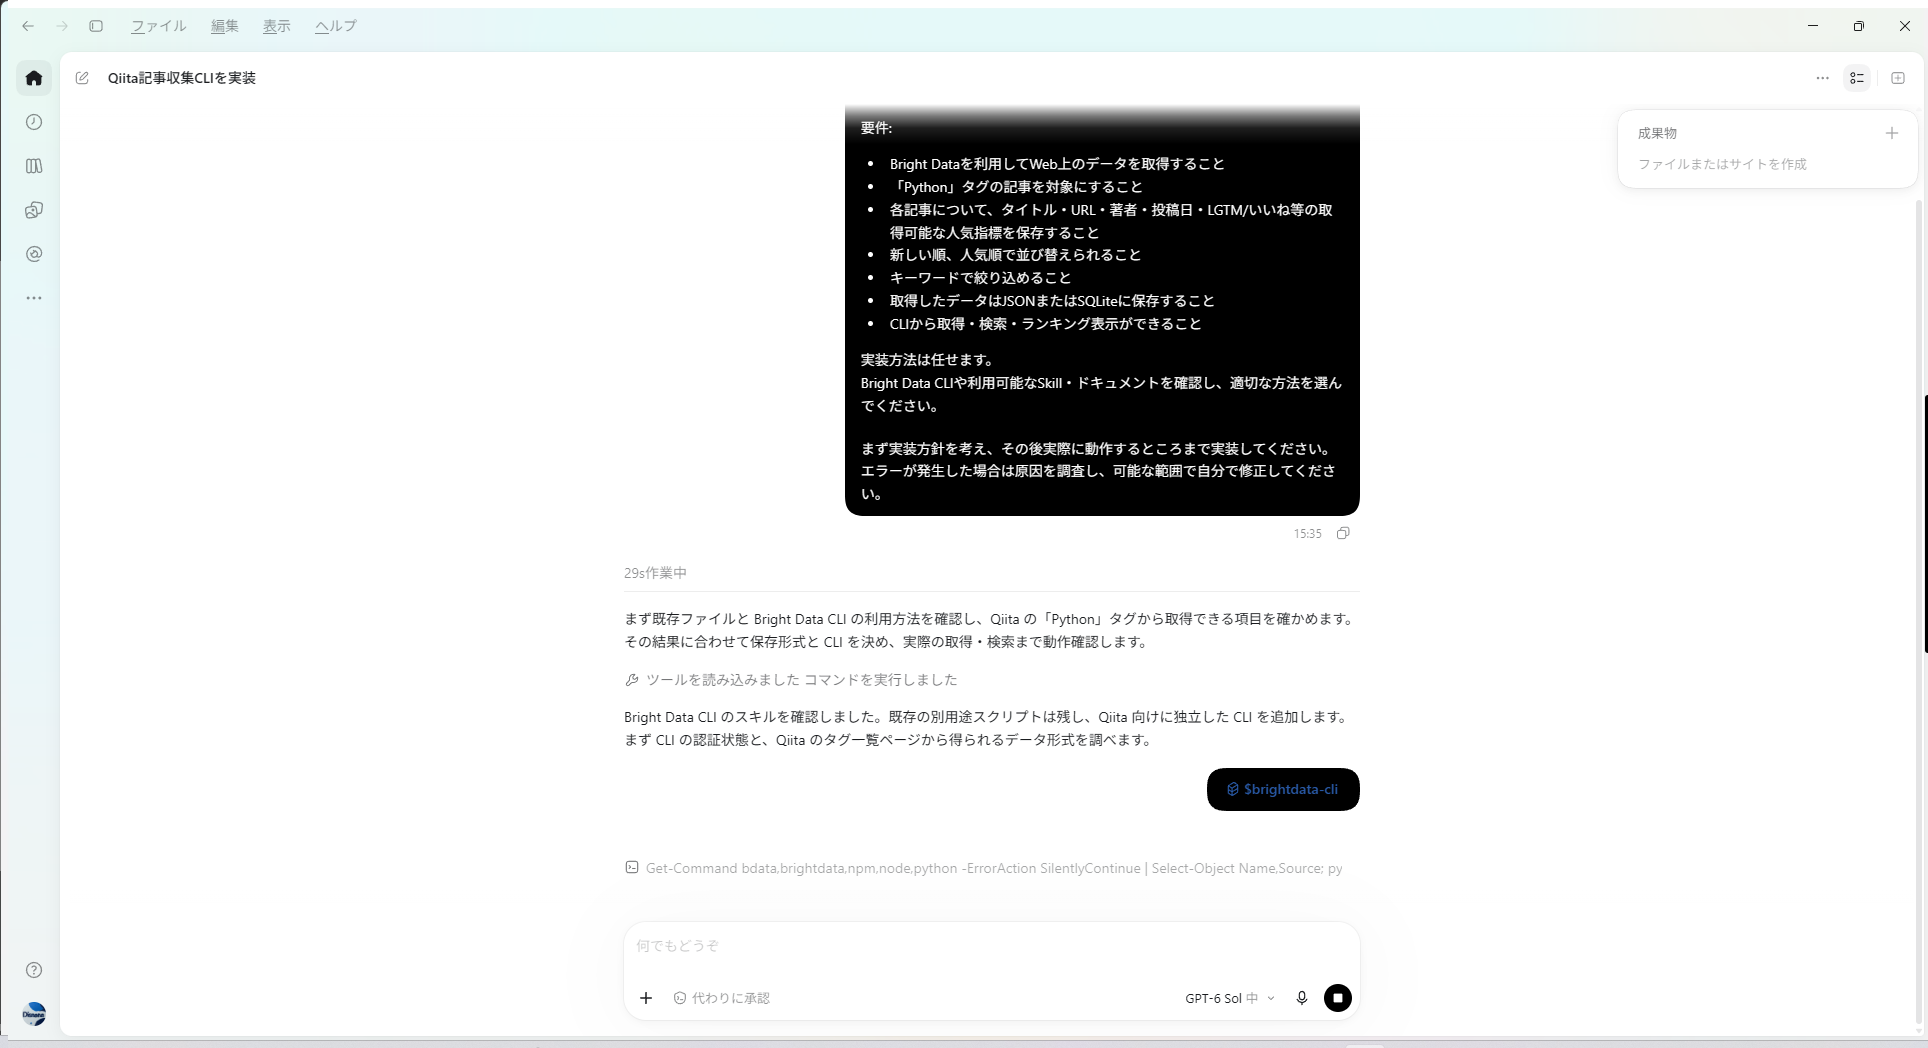
その後、データソースとしてQiita公式APIを選択。
APIなら投稿日・著者・いいね数など、欲しい項目がまとまって取得できるため、最初の選択としては自然だった。
実装された主な機能は次の通り。
fetchsearchrank- SQLite保存
- テスト
python .\qiita_python.py fetch --pages 1
python .\qiita_python.py search pandas --sort popular
python .\qiita_python.py rank --sort new --limit 10
python .\qiita_python.py rank --sort popular --limit 10
1ページ目は20件取得でき、テストも3件通過した。
ここまでは順調だった。
2ページ目でHTTP 402
2ページ目の取得で止まった。
HTTP 402 / policy_20140注意
HTTP 402 の名称は「Payment Required」ですが、今回の原因を判断するうえで重要だったのはHTTPステータスそのものではなく、Bright Dataが返した policy_20140 の方でした。
この時点でCodexは処理を止め、途中結果はSQLiteへ保存しなかった。
原因を調べさせる
ここで人間側から追加指示を出した。
現在のエラーについて、directアクセスに逃げずに、Bright Data経由のまま原因を調査してください。CLIのSkillや公式ドキュメントも確認してください。
現在の取得方法に問題がある場合は、Bright Dataで利用可能な別の取得方法に変更して構いません。
修正後、複数ページから実際に記事を取得できることまで確認してください。
「直接アクセスに切り替えて回避する」のではなく、Bright Data経由のまま原因を追わせたかった。
Codexはこの指示を受けて、Web UnlockerとBrowser APIの両方を使って状況を確認した。
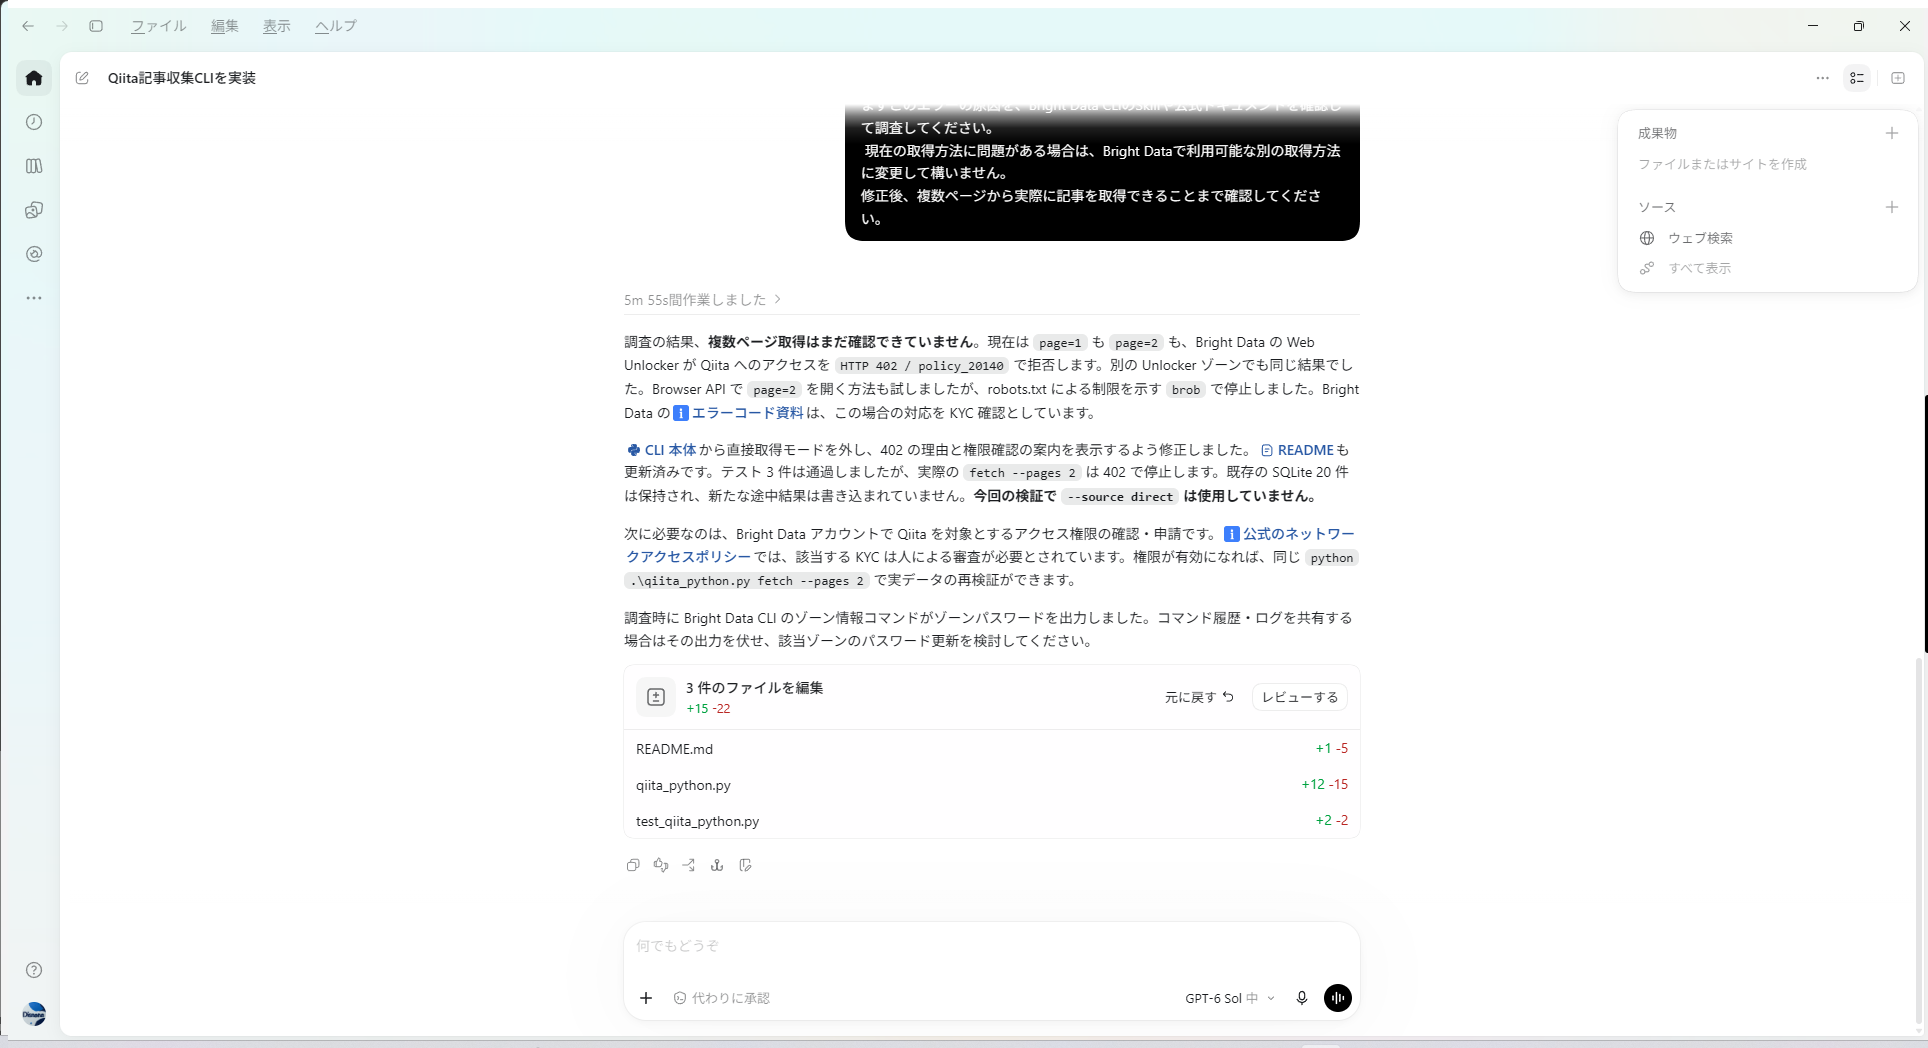
最初の調査では、KYCや追加権限が必要な可能性がある、という判断になった。
ただ、この時点ではまだ原因を絞り切れていない。
「KYCが必要」で止めず、もう一段掘る
ここでも人間側から再調査を指示した。
推測だけでKYCが原因と決めつけず、確認できた事実と推測を分けて報告してください。
認証情報やゾーンパスワードは出力しないでください。
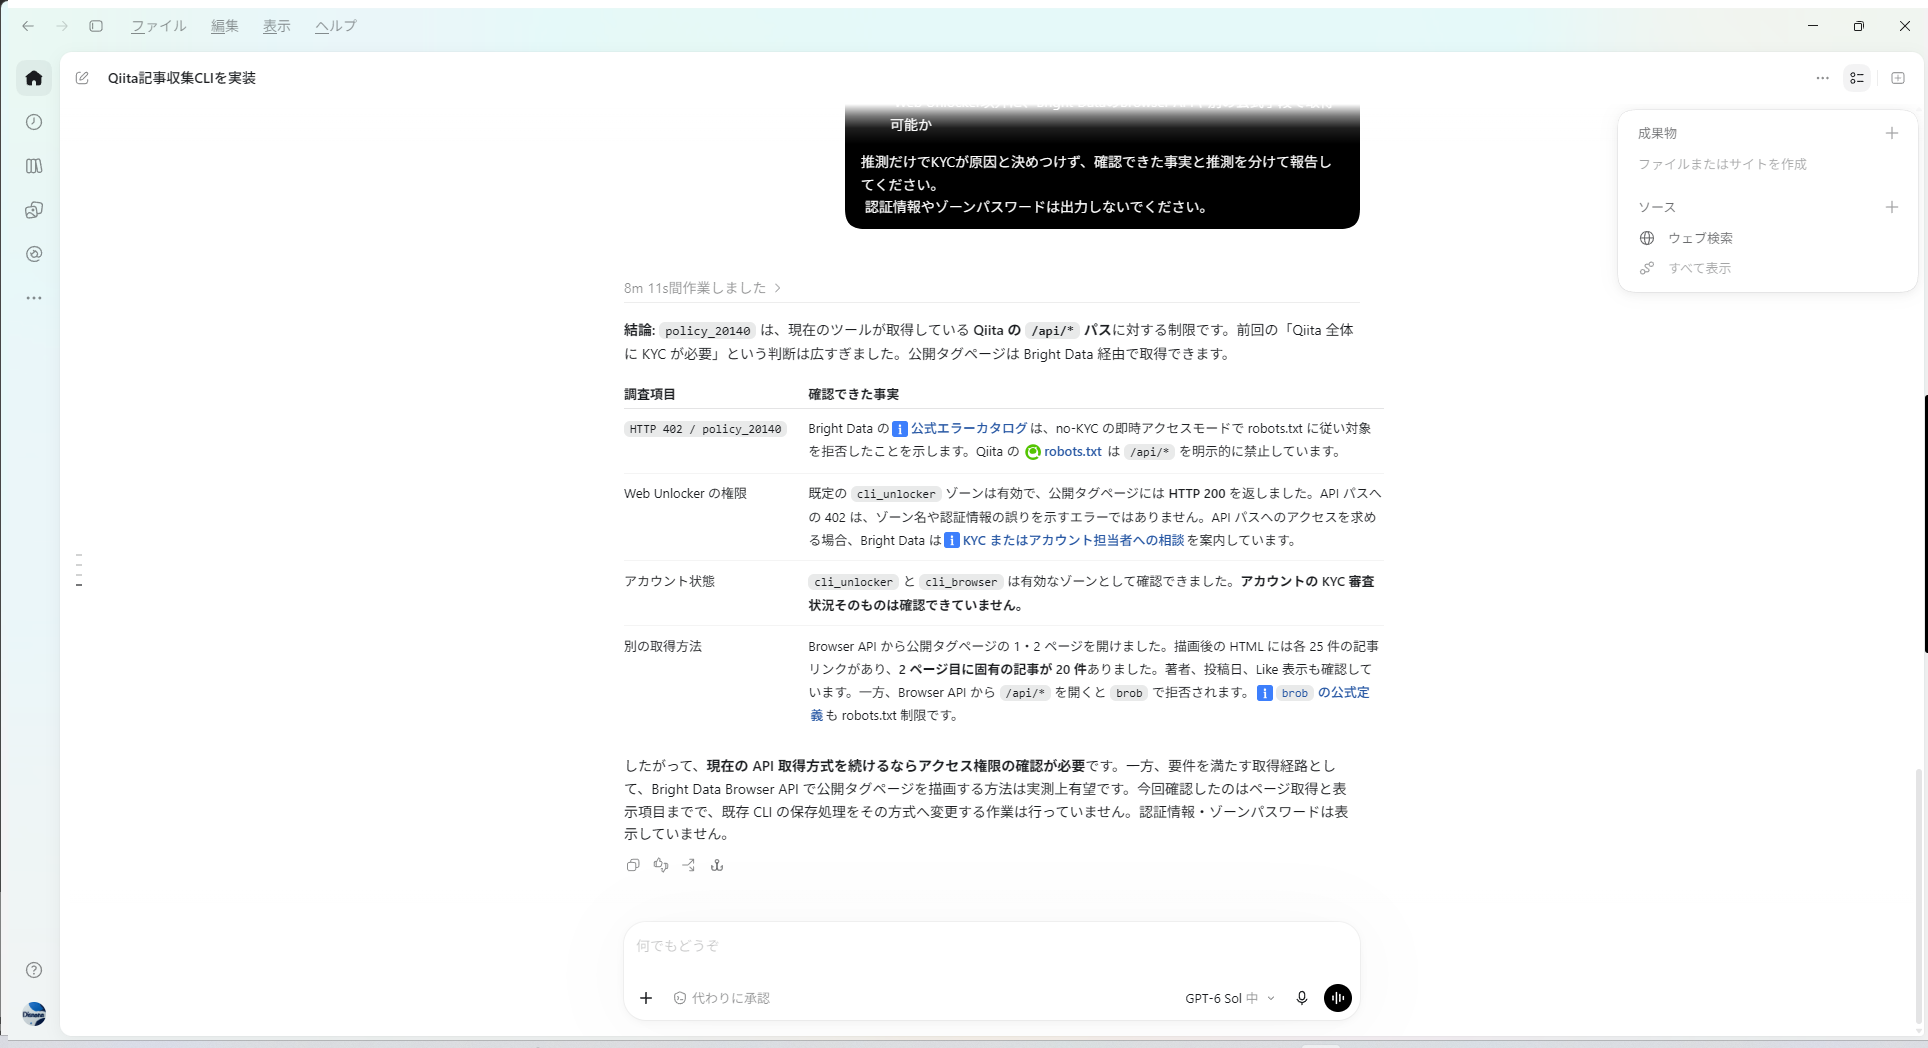
再調査の結果はこうなった。
| 調査項目 | 確認できたこと |
|---|---|
policy_20140 | 今回の条件では、robots.txtで禁止されている /api/* がno-KYCの即時アクセスモードで拒否されていた |
| Web Unlocker | 公開タグページ自体はHTTP 200で取得できる |
| アカウント状態 | cli_unlocker / cli_browser は有効。KYC審査状況そのものは未確認 |
| 別の取得方法 | Browser APIから公開タグページの1・2ページは取得できた |
情報
つまり、Qiita全体が取得できないわけではありませんでした。
問題になっていたのは /api/* の取得経路で、公開されているタグ一覧ページ自体はBright Data経由で取得できました。
最初の「KYCが必要」という判断だけでは、原因の説明として広すぎたことになります。
再調査の方針を出したのは人間だが、Web Unlocker / Browser APIの挙動やrobots.txt、エラー情報を突き合わせた具体的な調査はCodexが進めた。
Browser APIへ切り替えて45件取得
CodexはQiita公式APIを使う方式を捨て、Bright Data Browser APIで公開されているPythonタグページを描画して記事情報を取得する方式へ変更した。
取得対象も、公開ページから確認できる情報に絞った。
- タイトル
- URL
- 著者
- 公開日時
- 表示されているいいね数
ストック数・コメント数など、一覧ページから確認できない項目は保存対象から外した。
今回のように取得経路ごとに制限が異なるケースで、同じBright Data内の別手段へ切り替えられたのは実際に便利だった。
python .\qiita_python.py fetch --pages 2
python .\qiita_python.py search Python --sort popular
python .\qiita_python.py rank --sort new
python .\qiita_python.py rank --sort popular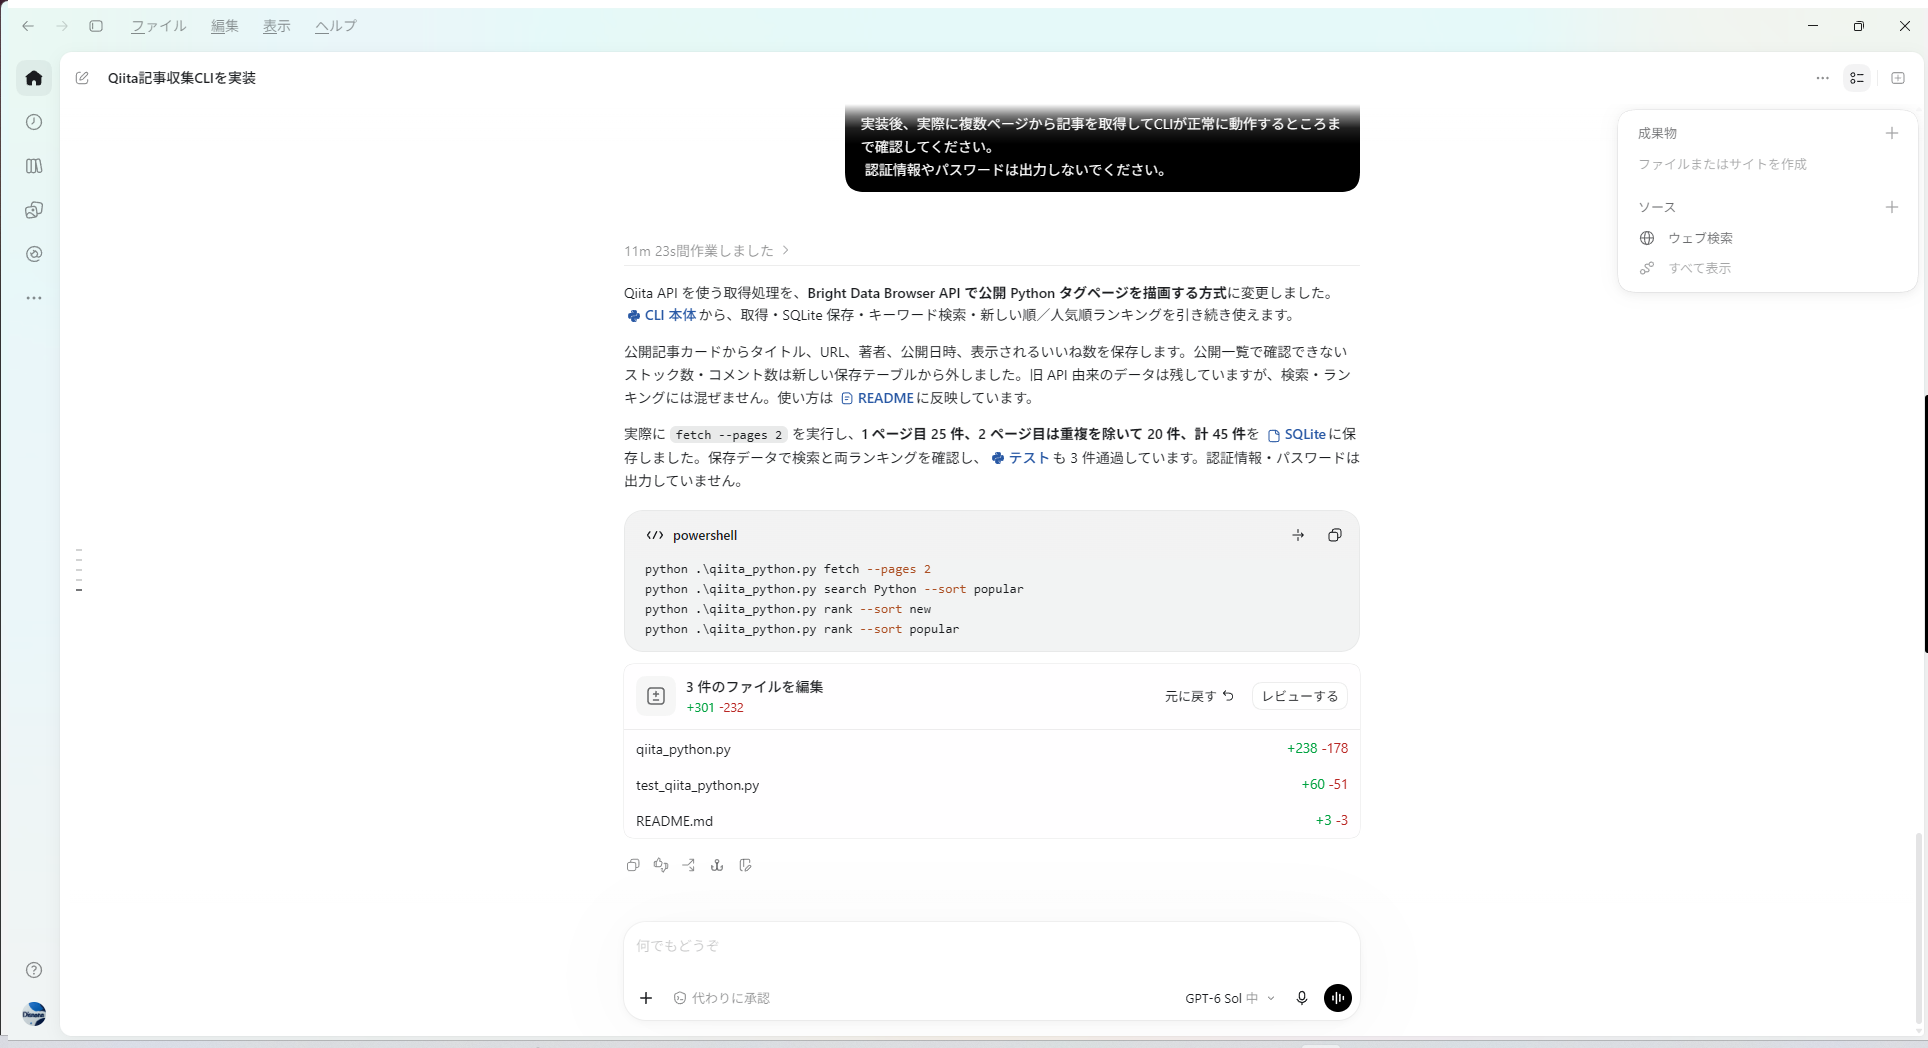
結果は次の通り。
- 1ページ目: 25件
- 2ページ目: 重複除外後20件
- 合計45件をSQLiteへ保存
- 検索・ランキング表示を確認
- テスト3件通過
当初の要件だった「複数ページからの取得・保存・検索・ランキング表示」まで到達した。
実際にどこまでCodexに任せられたのか
| Codexが自分で進めたこと | 人間が追加で指示したこと |
|---|---|
| Bright Data CLI / Skillの調査 | directアクセスへ逃げないこと |
| Qiita APIを使う方式の選択 | Bright Data経由のまま原因を調べること |
| CLI・SQLite保存・テストの実装 | KYCと決めつけず事実と推測を分けること |
| Web Unlocker / Browser APIを使った具体的な調査 | 認証情報を出力しないこと |
| Browser API方式への変更と再実装 |
情報
完全に自律していたわけでも、人間が答えを教えたわけでもありません。
人間は「どう調べるべきか」の方針を出し、具体的な調査手段の選択や実装はCodexが進める、という形でした。
AIエージェントに外部サービスを触らせるときの注意
今回一番ヒヤッとしたのは、調査中にBright Data CLIのゾーン情報コマンドがゾーンパスワードを出力したことだった。
注意
この記事に使ったスクリーンショット・コマンド履歴は、公開前に認証情報・パスワード・トークン等が含まれていないか確認しています。
AIエージェントに外部サービスのCLIやAPIを触らせる場合、ログやコマンド出力そのものに秘密情報が混ざる可能性があることは前提にした方がよさそうです。
また、一次情報を参照していても、その解釈まで必ず正しいとは限らない。
今回も「KYCが必要」という最初の判断をそのまま採用せず、もう一段掘ったことで /api/* 側の制限まで切り分けられた。
補足: Scraper StudioのCollectorについて
Bright Data CLIには、bdata scraper create でScraper StudioのCollectorを作成し、Collector IDを bdata scraper run で再利用する仕組みもある。
今回はCodex自身がQiita API → Browser APIという取得方法を選んだため、Collector中心の検証にはしていない。
次に試すなら、Collector IDをCODEX.mdなどへ固定して、セッションをまたいで再利用させる構成も試してみたい。
おわりに
今回面白かったのは、Codexが最初から正解を選んだことではなく、失敗したあとに別の取得方法へ切り替えて実装を立て直せたことだった。
途中では人間から「directに逃げない」「KYCと決めつけない」といった追加指示も必要だった。
それでも、具体的な調査方法や修正コードまで教えなくても、Web UnlockerやBrowser APIを試して原因を切り分け、最終的に2ページ45件を取得するところまで進められた。
「全部お任せ」ではないけれど、外部サービスを使う開発でも、Codexにかなりの部分を任せられそうだと感じた。
今回使ったBright Data
Bright Dataは、ISO 27001やSOC 2などのセキュリティ・コンプライアンス基準に対応しており、2万社以上の導入実績があります。
今回の検証では、公開されているQiitaのタグページ・記事情報のみを対象にしました。
情報
Bright Dataを試す
こちらの専用リンクから登録できます。
- 専用リンク経由で、案内上はAPI検証用の $20無料クレジット
- Scraper Studioは 毎月5,000ページロードの無料枠
- クレジットカード登録不要
※上記リンクはBright Dataの専用トラッキングリンクです。
注意
特典内容や対象プラン、併用条件は変更される可能性があります。登録時に表示される条件と、ダッシュボードへ反映された内容を確認してください。